
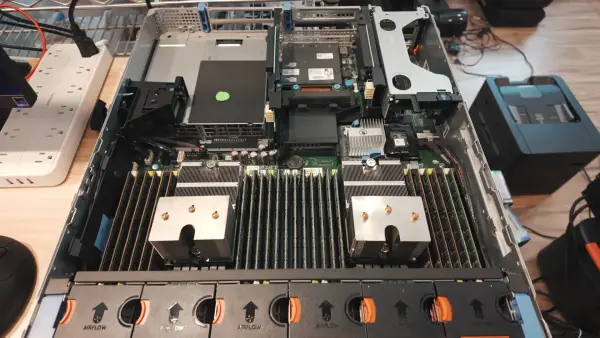
Існують численні причини для запуску великих мовних моделей (LLM) локально: від міркувань конфіденційності до простого бажання експериментувати з технологією. Однак, щоб запускати великі моделі, зазвичай вважається, що потрібні значні кошти на великі обсяги відеопам’яті (VRAM). [MattMo] ставить це під сумнів у своєму недавньому відео, де йому вдалося запустити GLM 5.3 Flash, Qwen 3.8 Flash і Qwen 3.8 27B на 14-річному сервері без жодного графічного процесора (GPU).
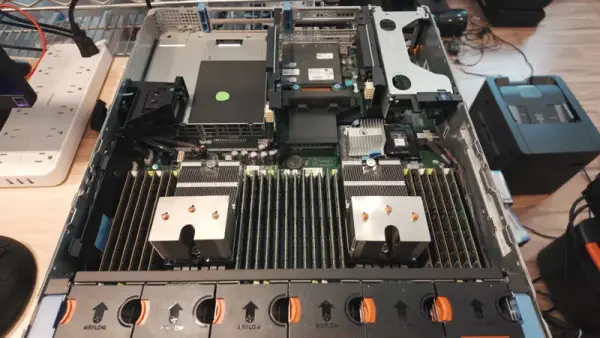
Секрет, якщо це можна так назвати, полягає в тому, що вони працюють не надто швидко: максимум чотири токени за секунду. Ці чотири токени генеруються двома процесорами Xeon старого сервера Dell PowerEdge R720, а моделі розміщуються в його 348 ГБ системної пам’яті DDR3. Цього достатньо навіть для найбільших флагманських моделей, але, як видно зі швидкості, виникає певне вузьке місце через наявність лише 20 потоків між двома процесорами. Ці процесори також достатньо старі, щоб не мати певних інструкцій, які могли б прискорити роботу. Тим не менш, [MattMo] стверджує у відео, що це не просто “танцюючий ведмідь”: існують робочі навантаження, де пакетна обробка зі швидкістю 4 токени/сек може бути доцільною, і є люди, які вже мають сервери такого класу, що простоюють у своїх домашніх лабораторіях. Перетин цих груп, ймовірно, досить невеликий, але якщо це про вас — чудово! [MattMo] каже, що це працюватиме, тож спробуйте.
Якщо б довелося купувати таке обладнання, то на вторинному ринку воно також коштує досить розумно. [MattMo] оцінює його приблизно в 600 доларів США, враховуючи поточні ціни. Він також зазначає, що новіші моделі можуть отримати певну оптимізацію для покращення швидкості, але не варто очікувати розмов у реальному часі з HAL 9000. Тим не менш, з точки зору локальних LLM, це, безумовно, перевершує іграшкові моделі, що працюють через Llama на PSP або Commodore 64.