
Існує безліч речей, які ми спрощуємо, щоб полегшити собі життя. Наприклад, дроти не мають опору чи інших незвичайних ефектів. Кварцові генератори видають точну частоту. Але, безперечно, наша модель того, як комп’ютер зберігає та завантажує пам’ять, є точною, чи не так? Ви розміщуєте дані у певному місці, а потім витягуєте їх. Розробники [FEX-Emu] мають іншу точку зору. Як тільки з’являються кеші та, можливо, кілька процесорів, все стає не так просто.
Основна проблема полягає в наступному: якщо один процесор (або, точніше, головний пристрій шини) записує дані в певне місце, чи матиме інший процесор доступ до нового значення? Модель Total Store Ordering (TSO) процесорів x86 надає програмістам гарантії щодо того, коли операції читання та запису стануть видимими, тоді як ARM свідомо використовує слабшу модель пам’яті, яка допускає значно більше перевпорядкування заради продуктивності та ефективності.
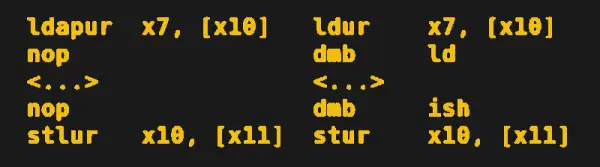
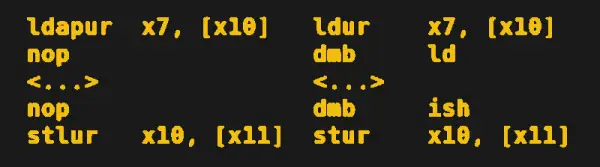
Емулятор може, теоретично, компенсувати це, перетворюючи звичайні операції пам’яті x86 на операції acquire/release ARM, але виконання цього майже для кожного звернення до пам’яті може бути витратним. Новіші розширення ARM, такі як LRCPC, значно допомагають, тоді як Apple пішла прямішим шляхом, додавши режим x86-сумісний TSO до Apple Silicon. Це дозволяє звичайним операціям читання та запису поводитися так, як очікує перетворений код x86, зі порівняно невеликими накладними витратами.
Ситуація значно ускладнюється з не вирівняними доступами та атомарними операціями. Програмне забезпечення x86 регулярно виконує доступи, які ARM вважав би погано вирівняними, а x86 надає напрочуд сильні гарантії атомарності в межах кеш-лінії. FEX іноді мусить перехоплювати помилки вирівнювання та динамічно виправляти перетворений код бар’єрами. Розділені блокування (split-lock) — це ще гірше: деякі з них потребують звернень через ядро та обробники сигналів і можуть бути в сотні чи тисячі разів повільнішими за звичайний випадок. Новіші ядра Qualcomm Oryon покращують ситуацію, підтримуючи узгоджені атомарні операції для кеш-ліній, тоді як Valve випустила оптимізацію ядра Linux, яка безпосередньо обробляє деякі проблемні не вирівняні атомарні операції.
Існує ще один особливо неприємний аспект, пов’язаний із пам’яттю GPU, що комбінується з записом (write-combined). Комп’ютерні ігри часто очікують семантики x86-подібного порядку запису в буфери без кешування, призначені для дискретного GPU. ARM наразі не має чистого еквівалента для деяких із цих операцій запису, а FEX виміряв найгіршу пропускну здатність більш ніж у 800 разів повільнішу, що достатньо для зниження продуктивності деяких ігор до менш ніж 1 кадру на секунду. Системи UMA (Unified Memory Architecture) поводяться набагато краще, оскільки драйвери часто можуть замінити їх звичайними кеш-когерентними пам’яттю.
Це довга стаття, але вона добре ілюструє, чому сучасні емулятори менше займаються перетворенням інструкцій, а більше відтворенням десятиліть архітектурних припущень, на які програмне забезпечення тихо спирається. Звісно, не всі емулятори чи відтворення процесорів настільки точні, і часто цього достатньо. Але іноді потрібне відтворення, яке є справді точним до циклу та поводиться точно так само, як оригінал.